
产品与算力
模组、终端、工作站与服务器完整覆盖,承载从轻量推理到高密度计算的不同负载。
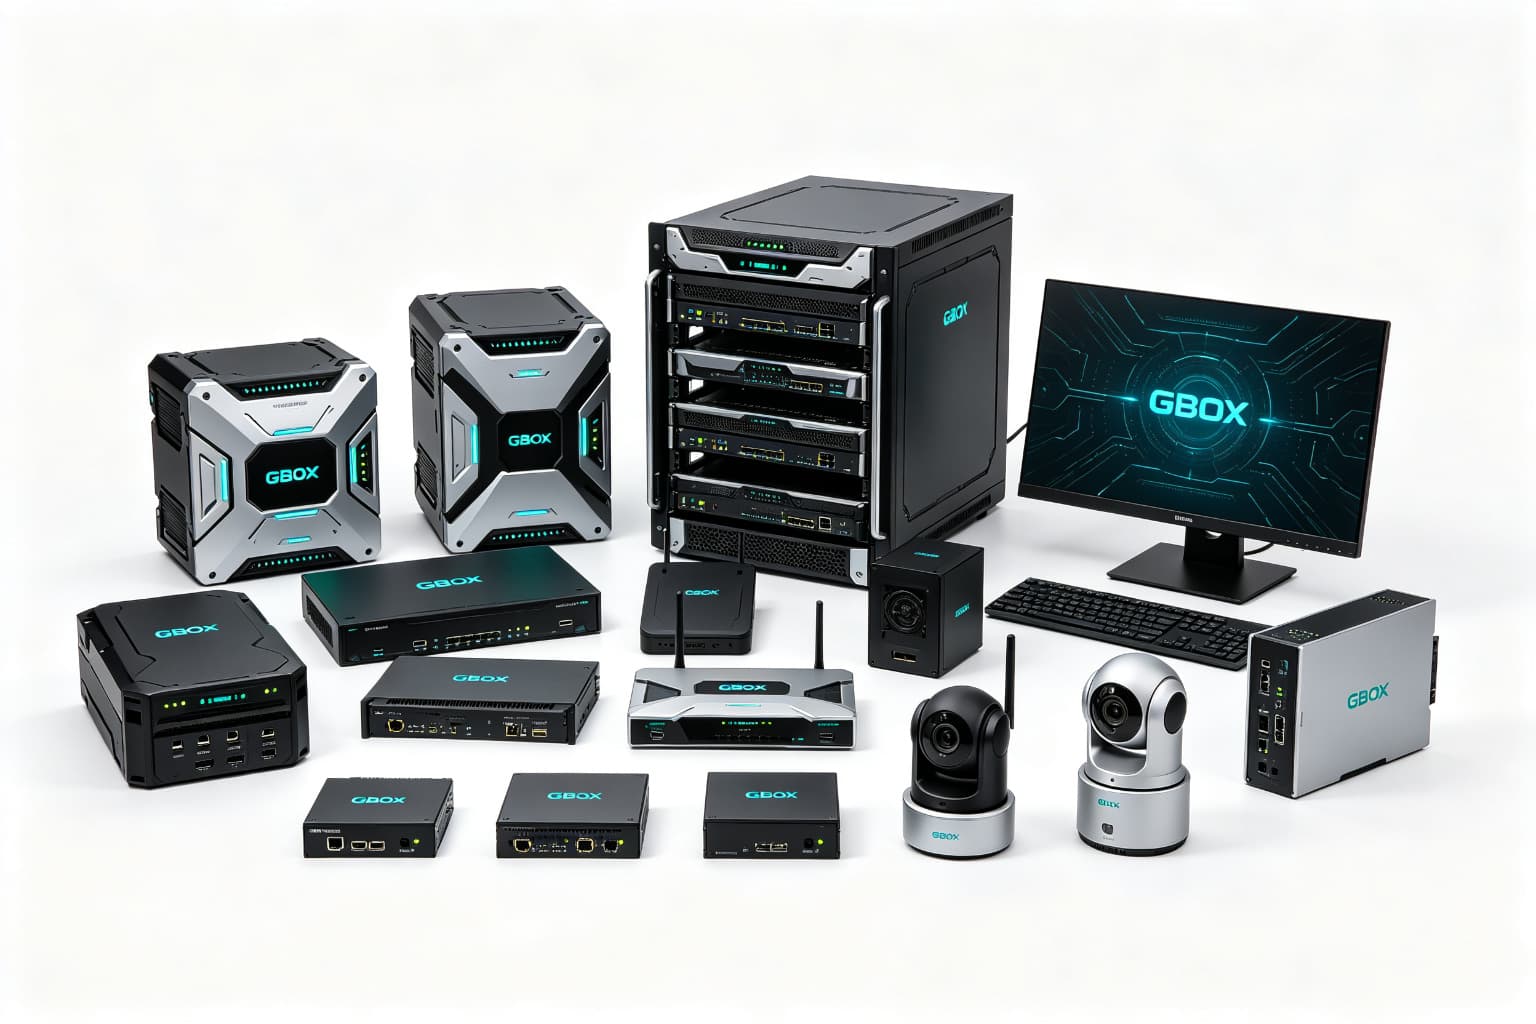
从产品选型、芯片适配到系统交付,将端、边、中心的硬件能力统一起来。
模组、终端、工作站与服务器完整覆盖,承载从轻量推理到高密度计算的不同负载。
兼容国产芯片及 NVIDIA 端侧与数据中心平台,以统一接口降低跨平台适配和迁移成本。
宽温、宽压、连续运行与国产化配置并重,满足户外、工业及自主可控部署要求。
覆盖选型、算法移植、系统集成与现场部署,缩短方案验证到规模化落地的周期。
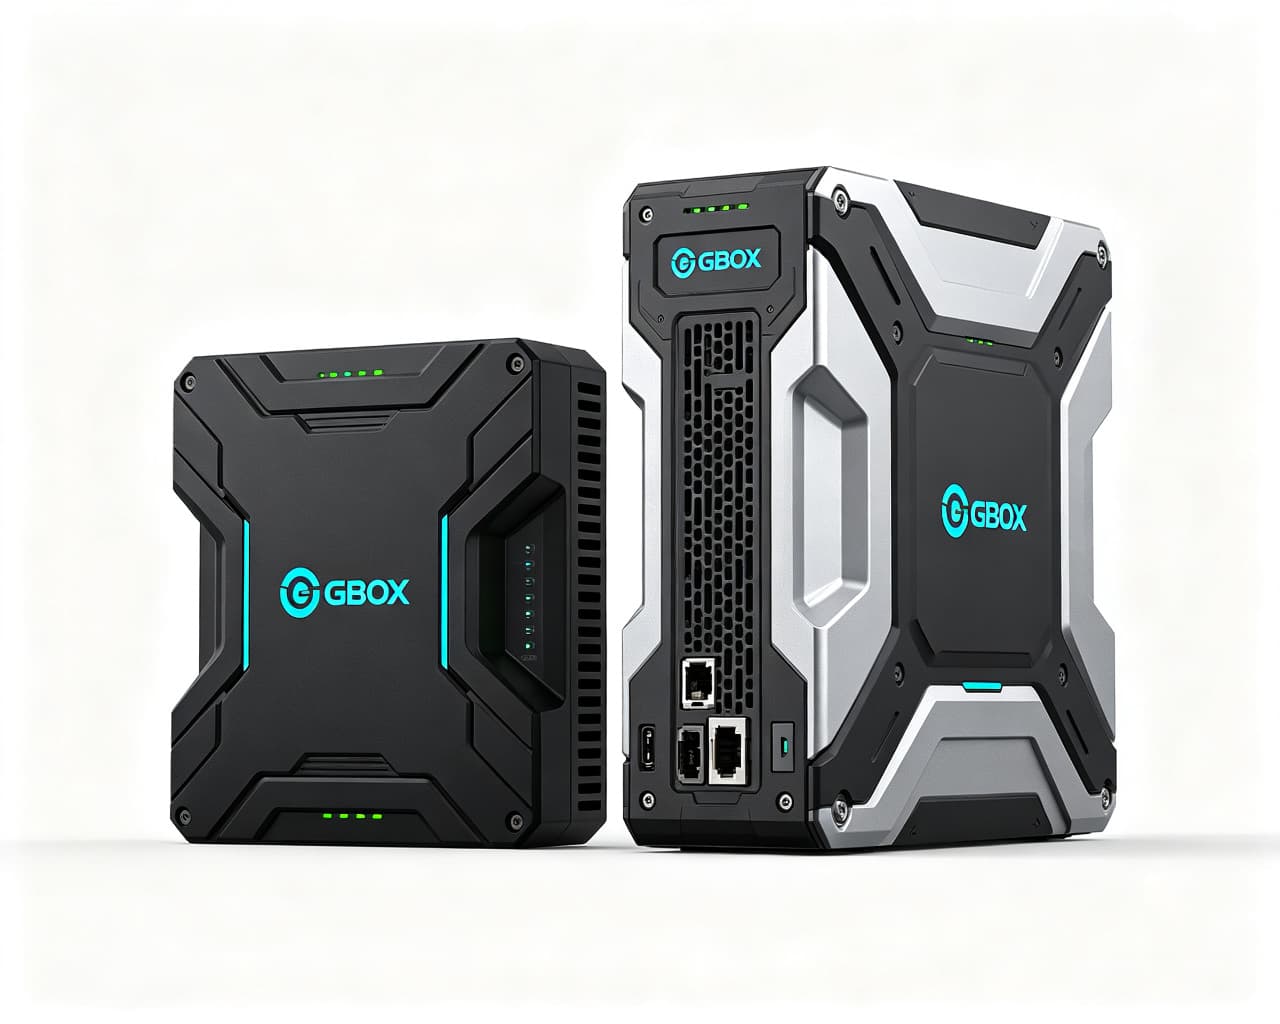
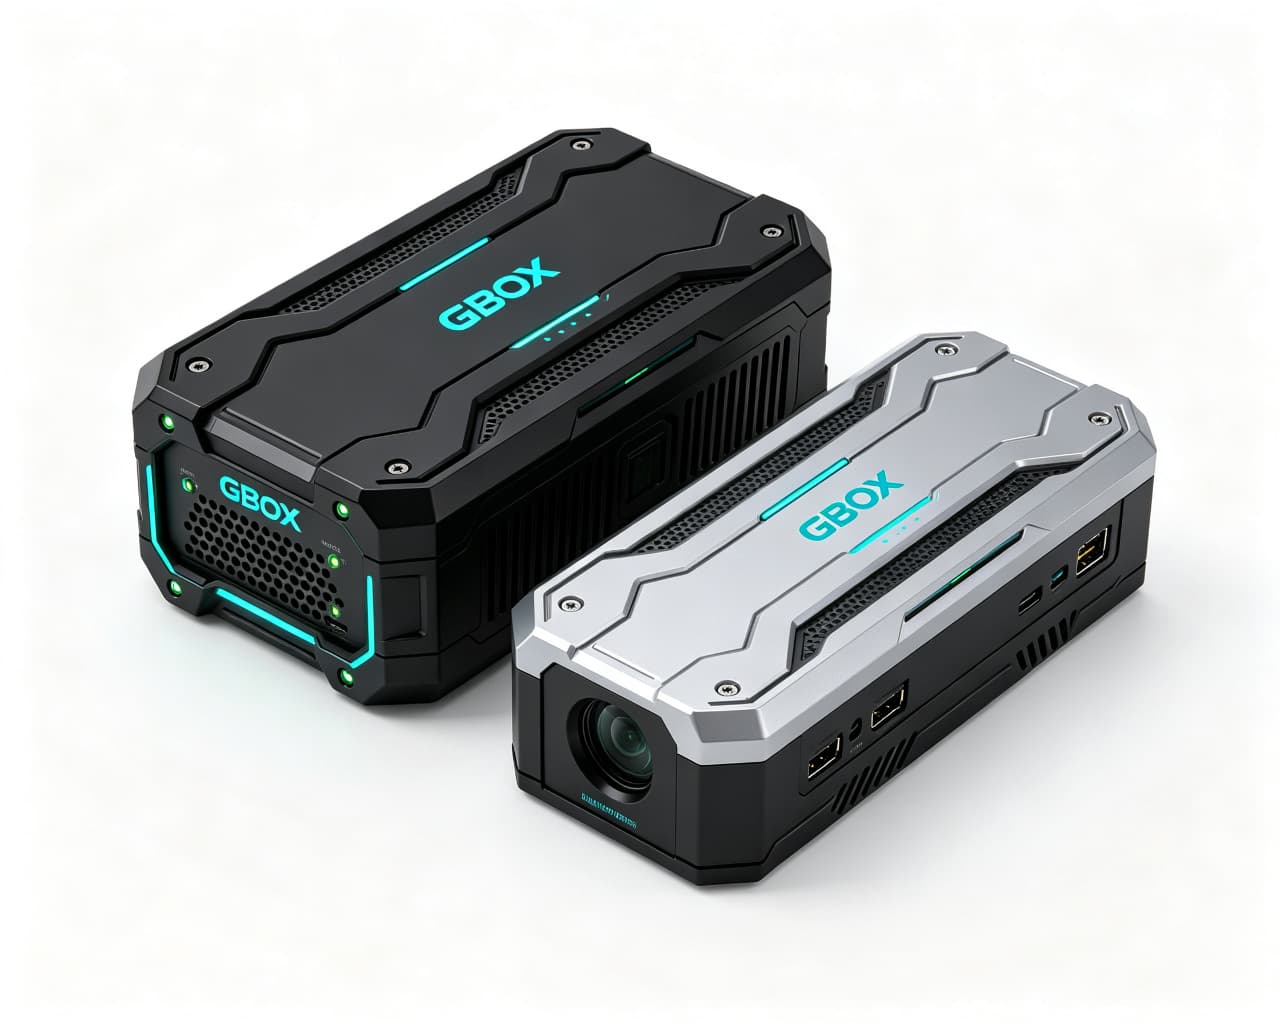
边缘计算终端与边缘计算主机全品类覆盖,多形态硬件一站选型
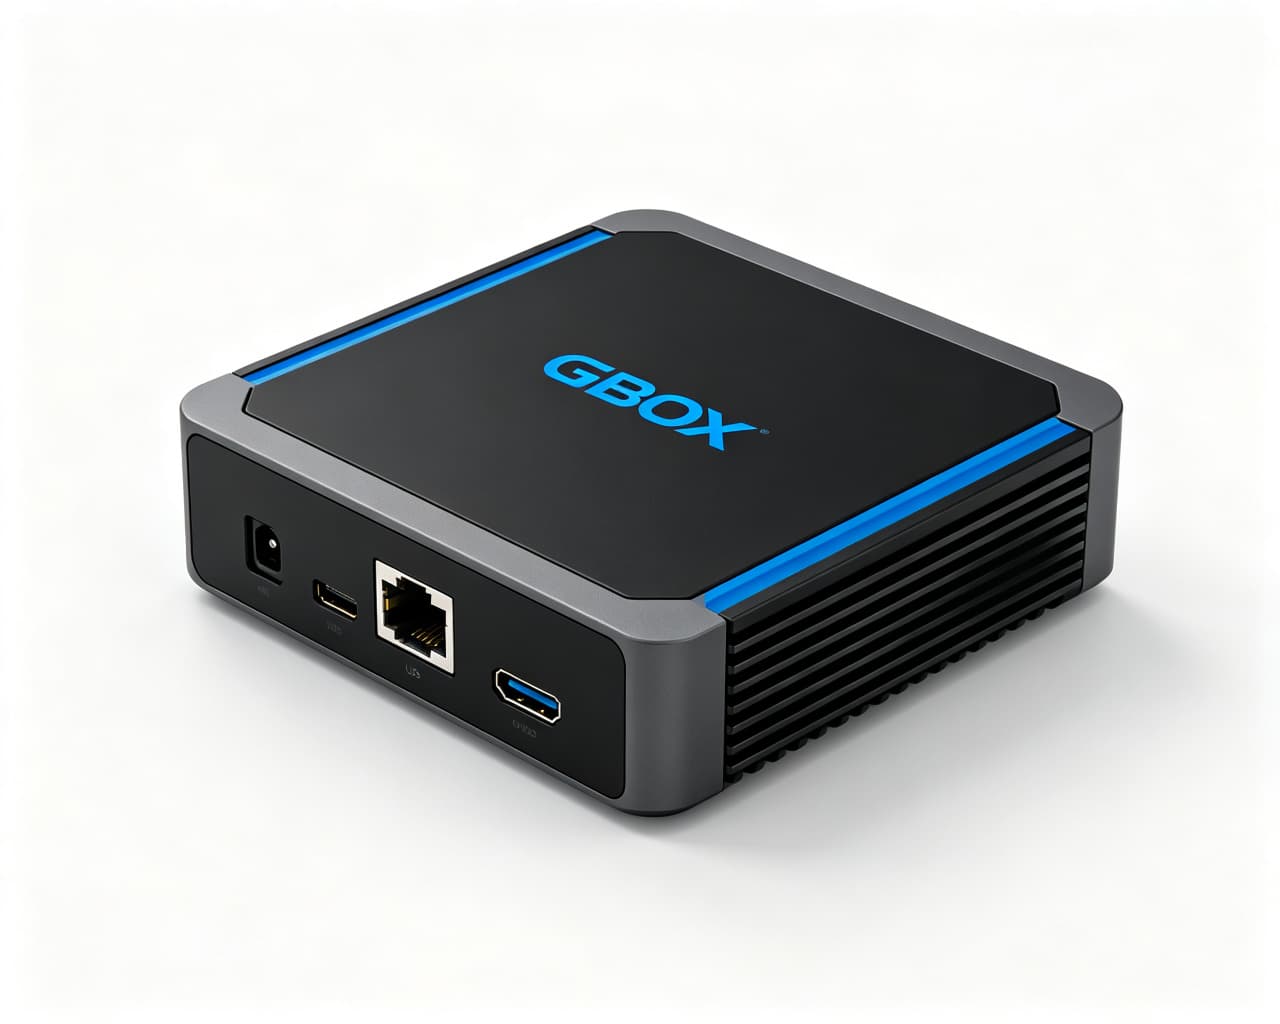
AI 算力0.5–5 TOPS
超小体积低功耗设计,适配前端嵌入式场景,支持多路轻量算法推理与视频结构化。
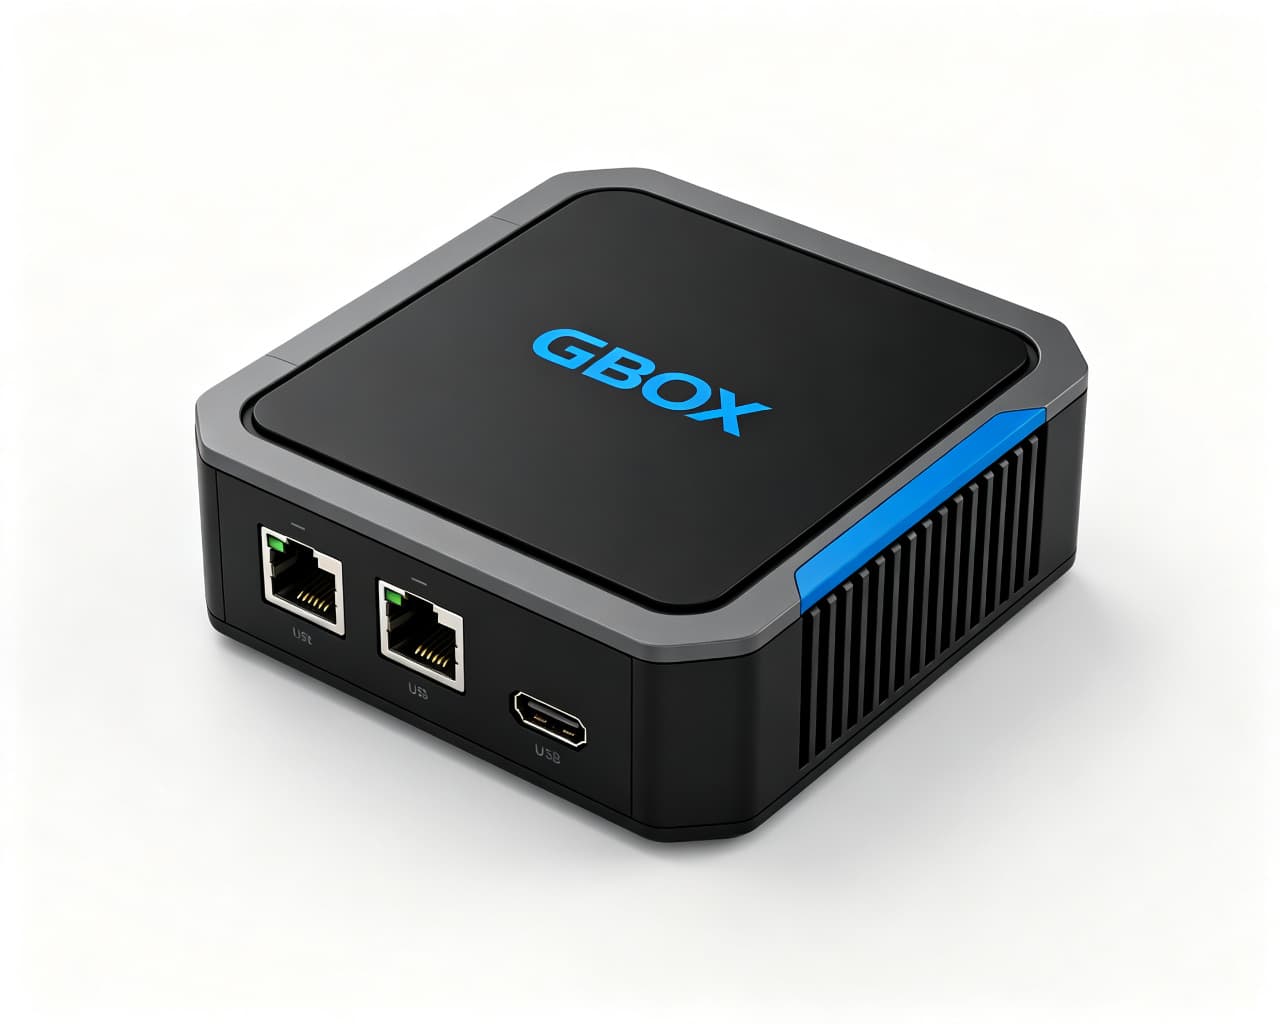
AI 算力5–20 TOPS
均衡算力与成本,支持多路并发算法推理,适用于中小场景边缘智能分析。
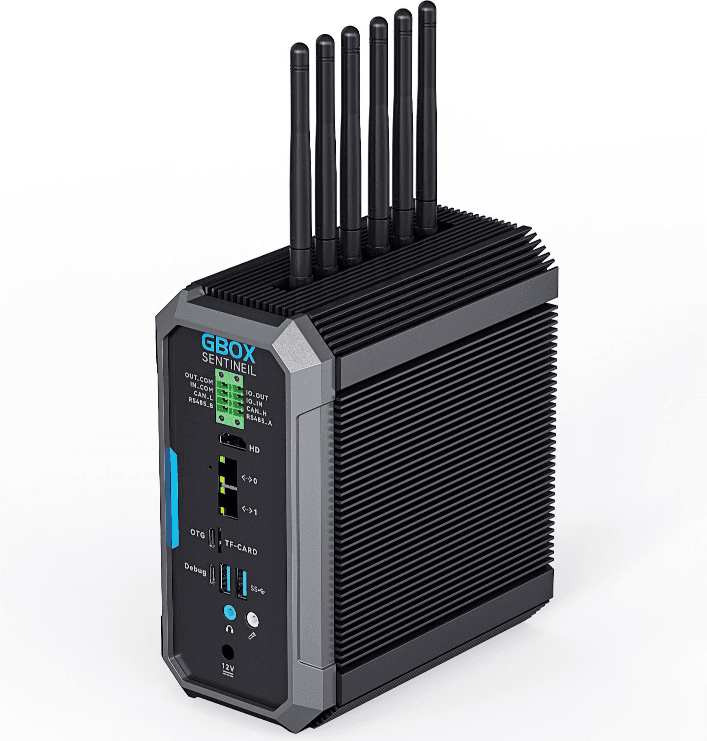
AI 算力20–80 TOPS
高性能算力输出,支持大模型端侧推理与多算法协同,满足高端边缘智能需求。
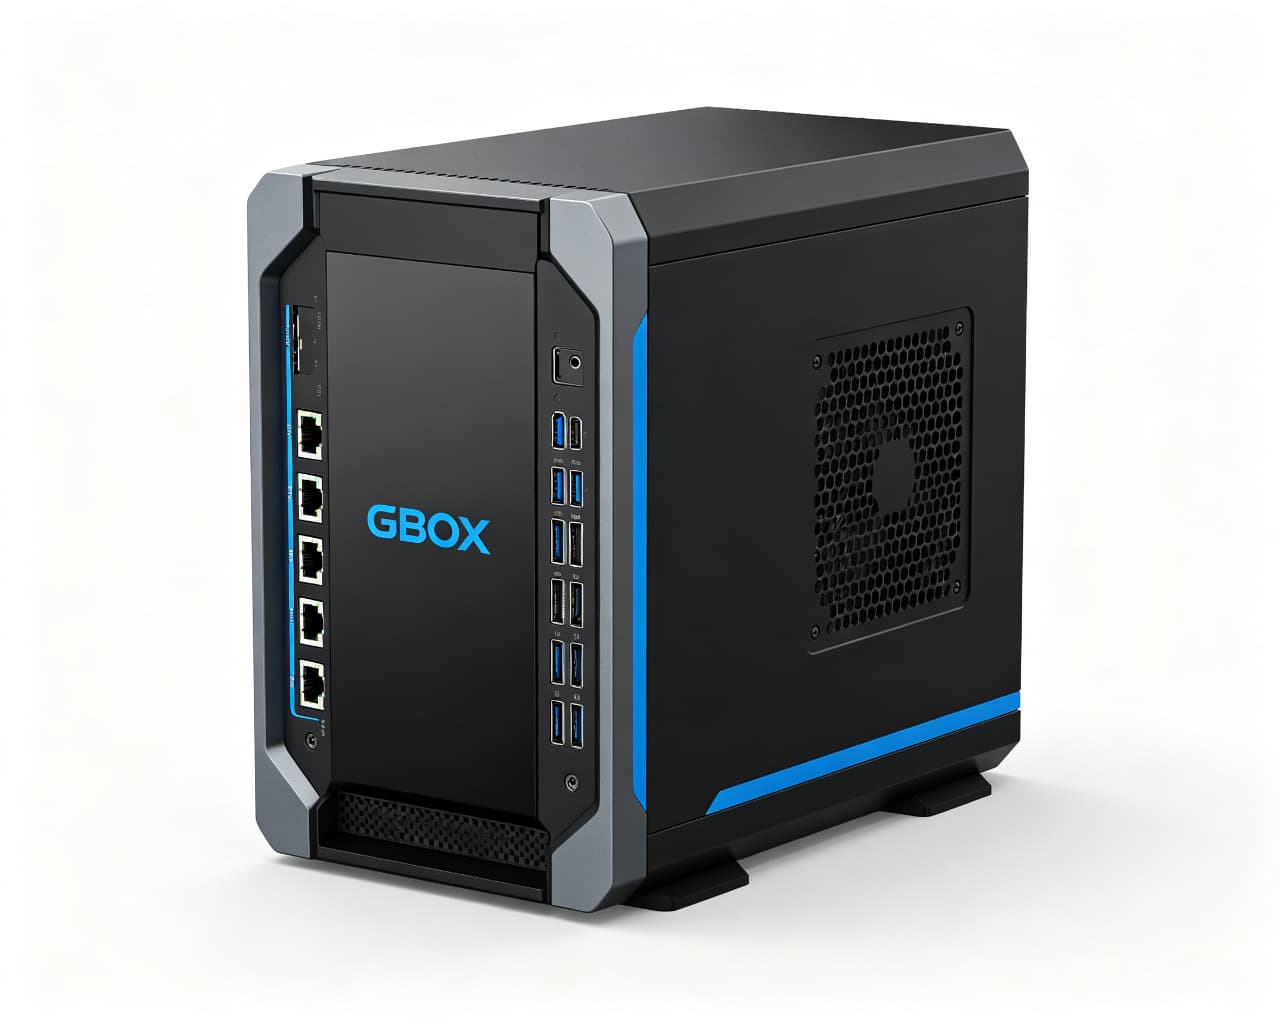
AI 算力80–300 TOPS
大算力密度设计,主动散热方案,四网口配置,支持 NVIDIA 终端芯片(Orin / Spark / Thor 等)及国产高算力芯片,性能强劲。
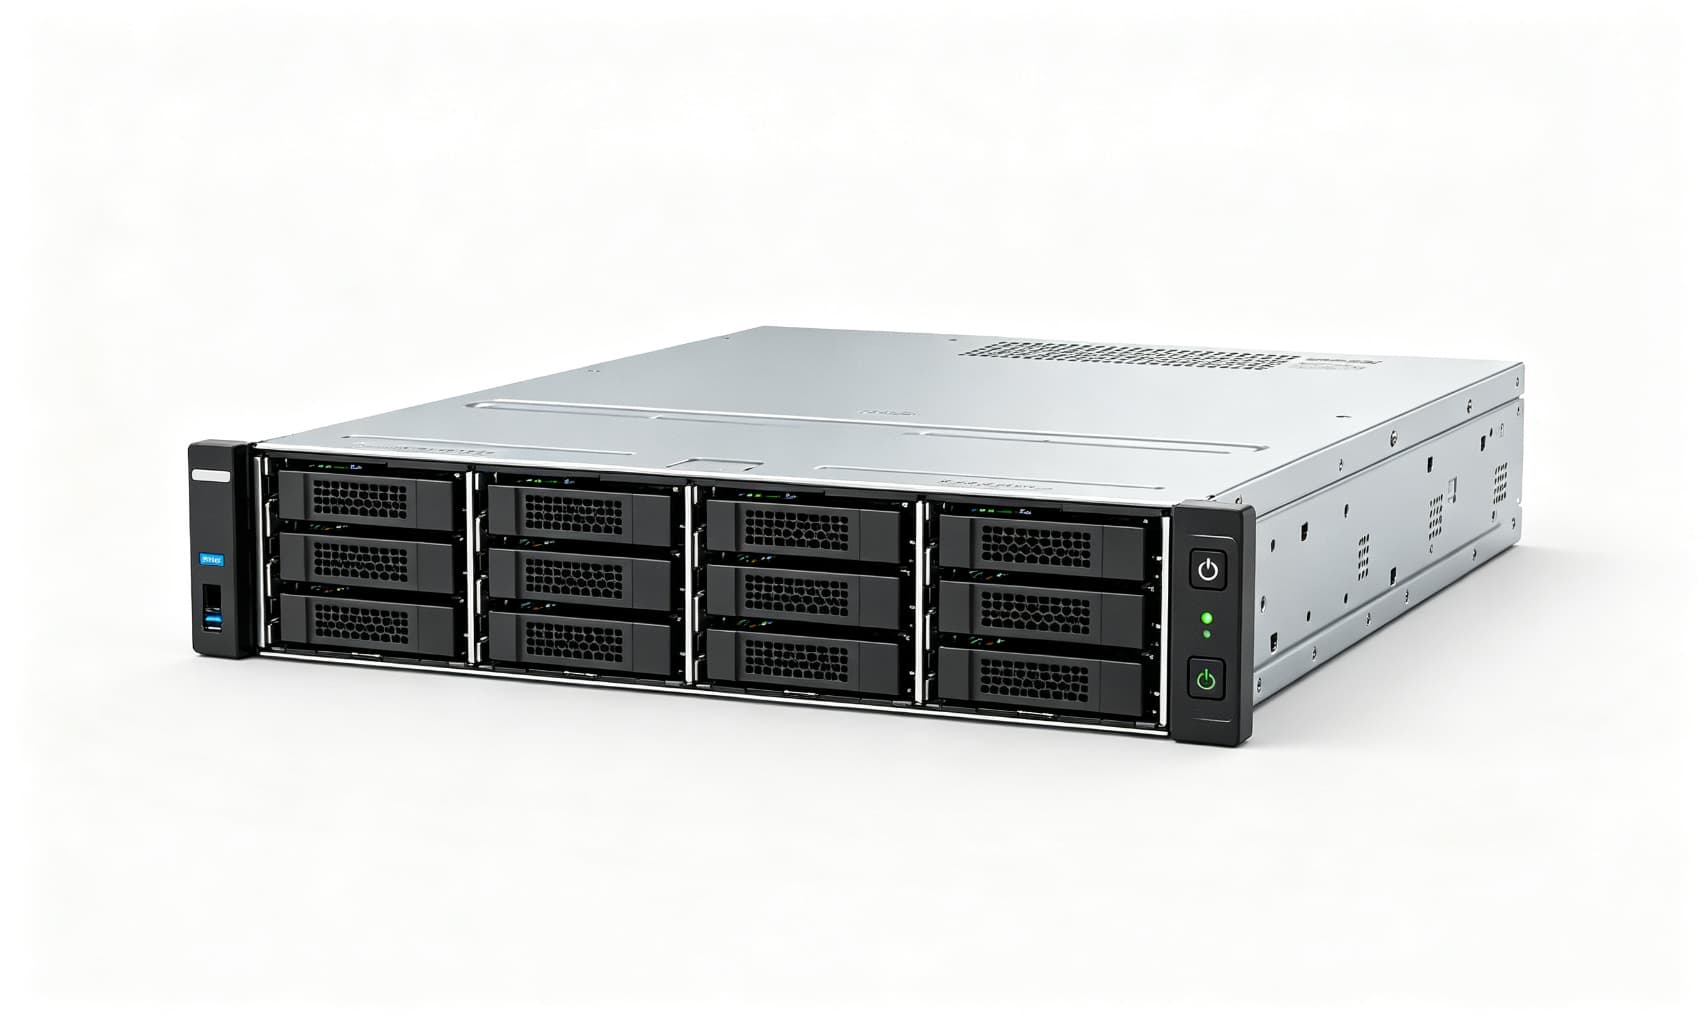
AI 算力300 TOPS 以上 · 可配置
2U/3U 机架式超算服务器,支持 NVIDIA 计算卡及国产高端芯片,满足大规模模型推理与高并发算力集群调度。
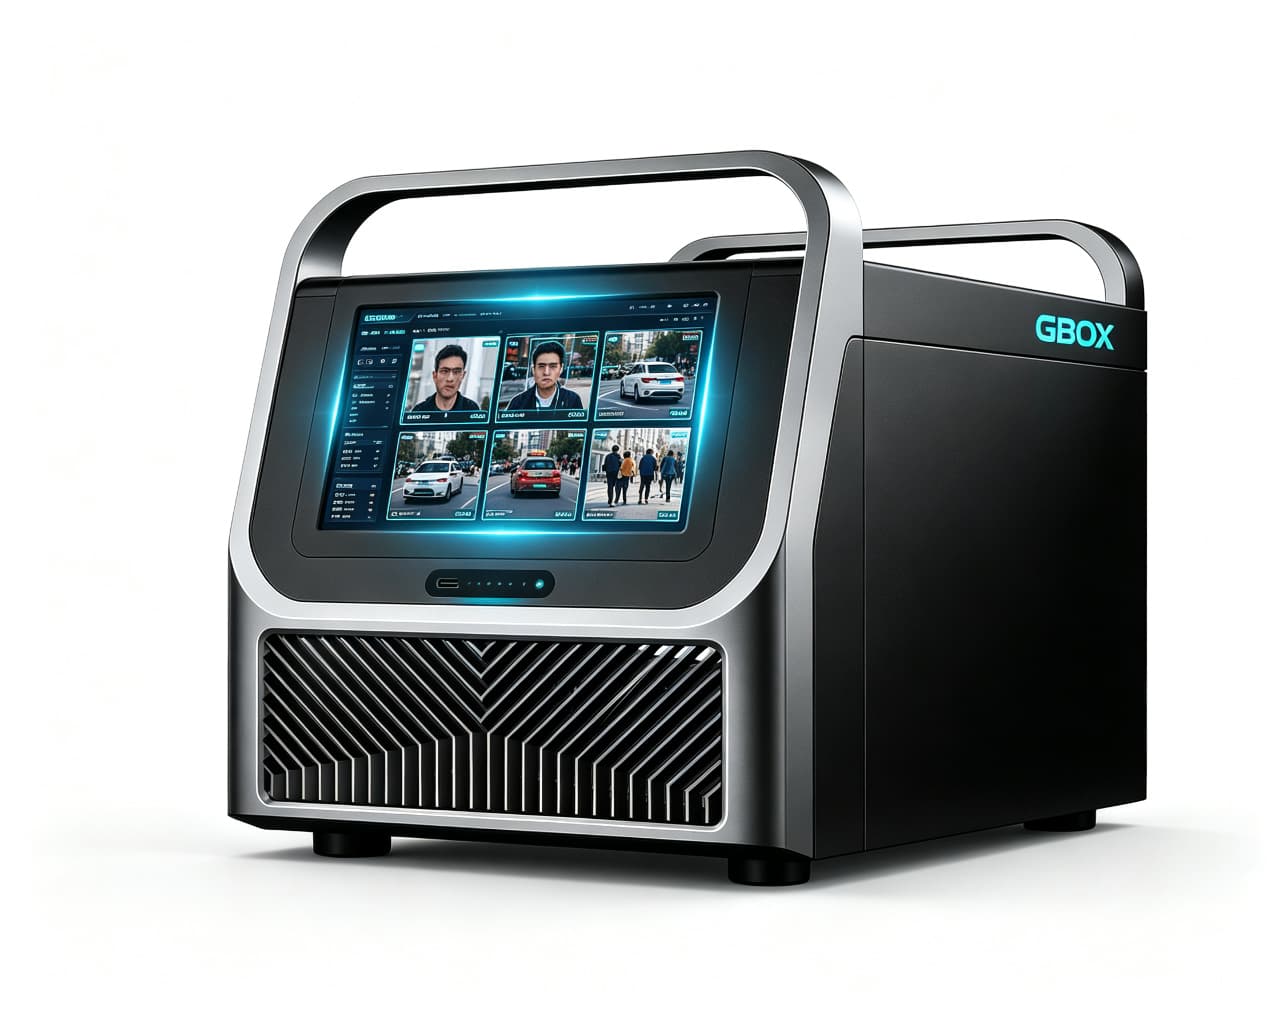
AI 算力300 TOPS 以上 · 可配置
便携式/台式高性能工作站,风冷散热设计,适配桌面部署与移动作业场景,支持国产高端 GPU 与通用 GPU,满足本地大模型推理与可视化计算需求。
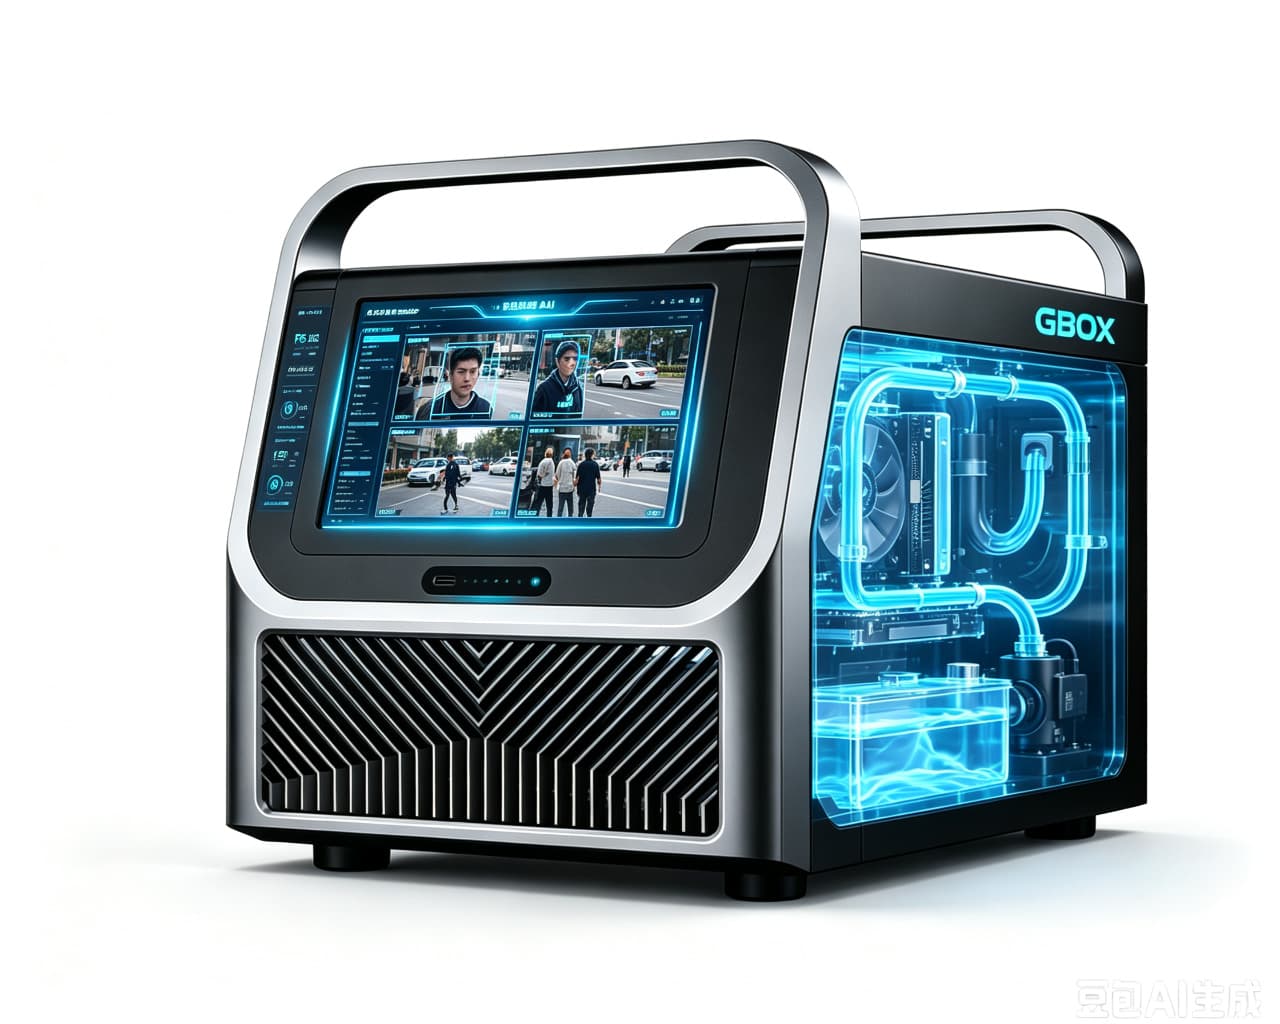
AI 算力300 TOPS 以上 · 可配置
高性能液冷工作站,侧面透明展示内部液冷散热系统,高效静音散热,支持更高功耗 GPU 长时间满负载运行,满足大规模模型训练与推理需求。

AI 算力300 TOPS 以上 · 多卡扩展
4U 高扩展机架式服务器,支持多 GPU 全高全长卡与大量存储扩展,满足超大规模模型训练、推理与高密度算力集群部署需求。
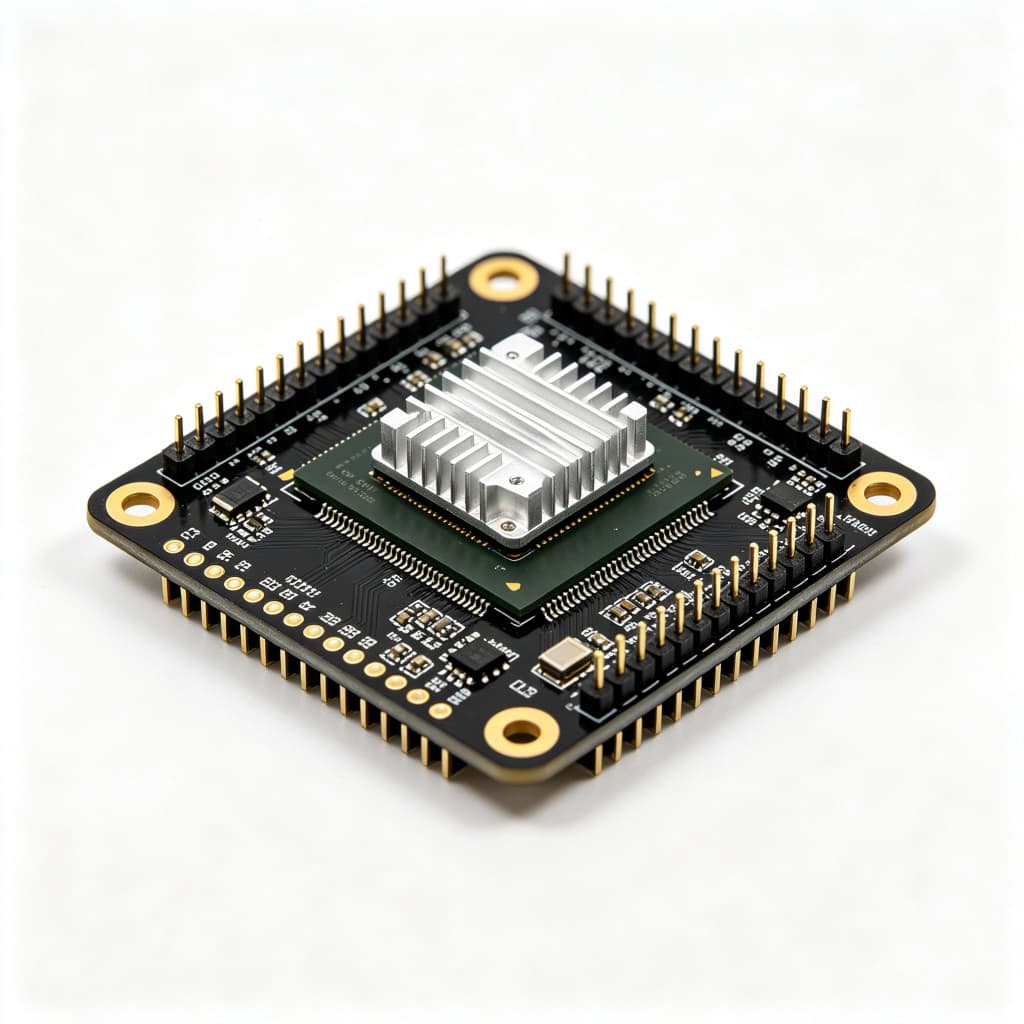
多路高清视频实时压缩编码,低码率高画质,支持 H.265/H.264 编码格式,体积小巧适配前端嵌入。
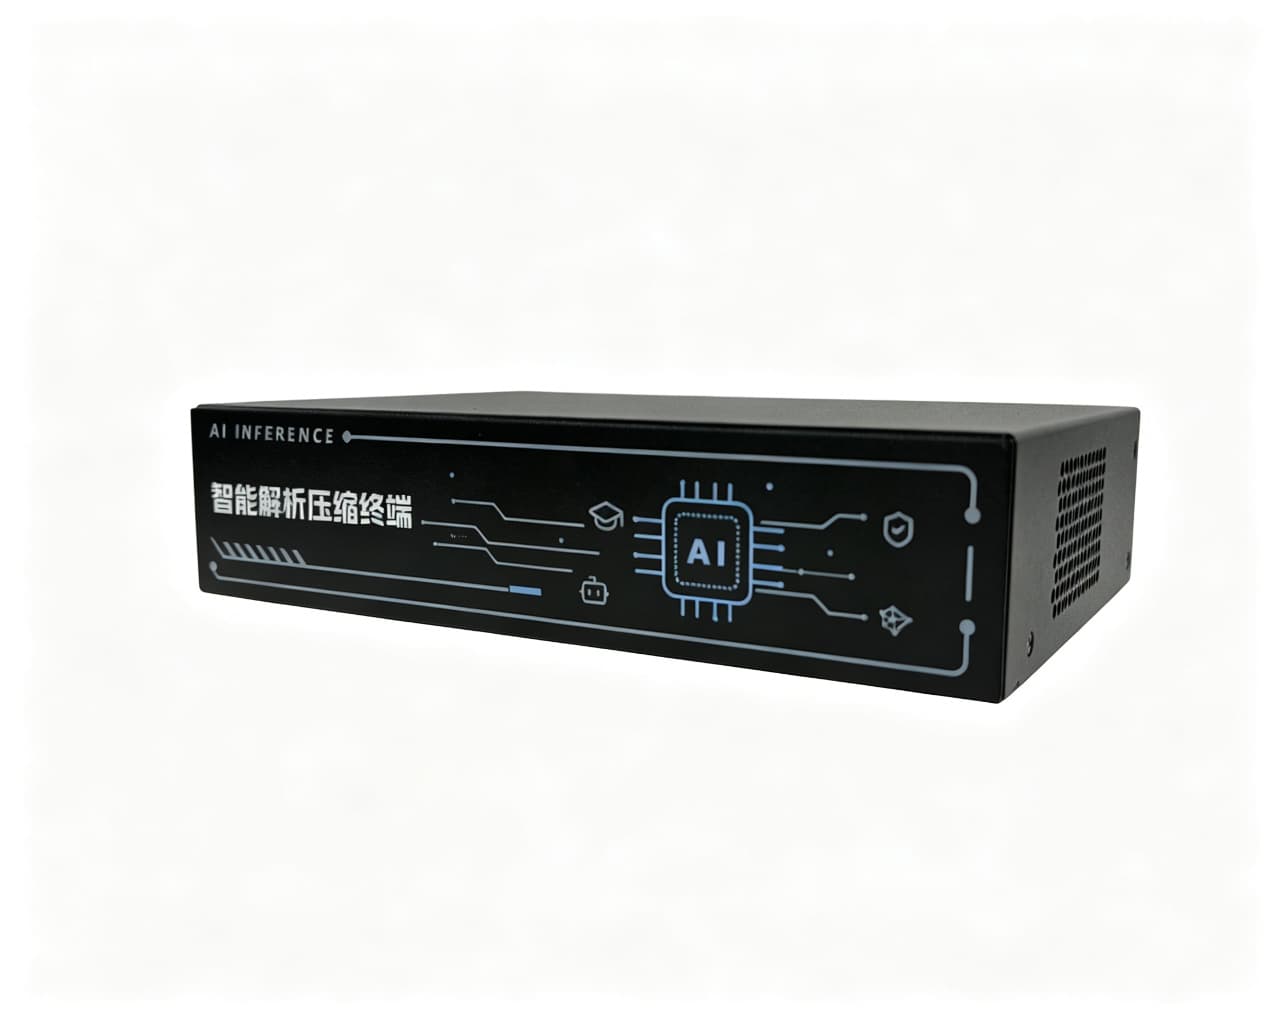
边缘侧多路视频压缩与转码,支持上百路视频接入,适用于监控中心、视频汇聚等场景。
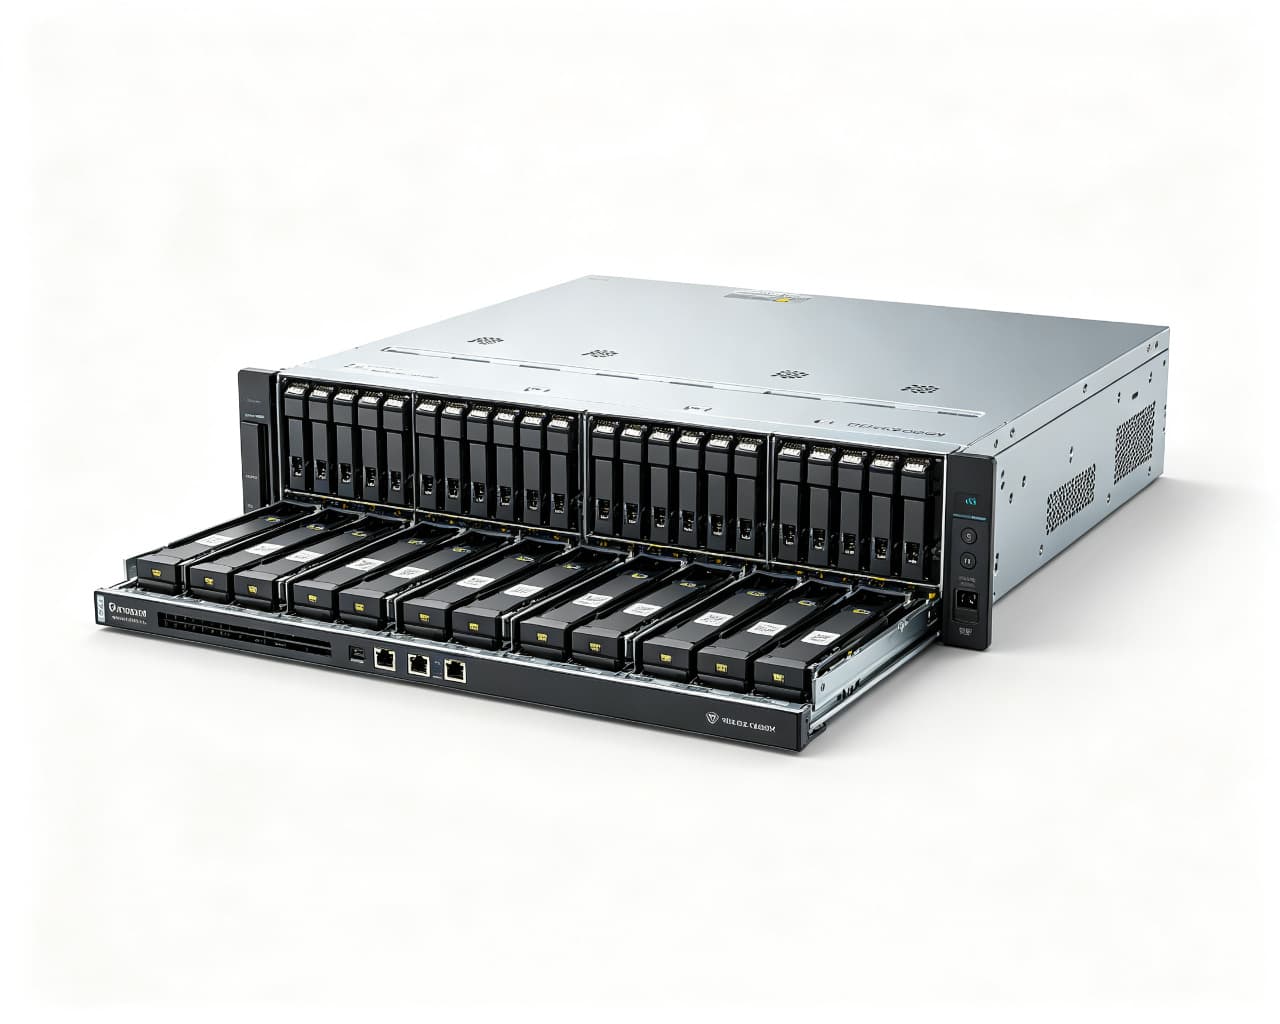
机架式高密度视频压缩阵列,支持大路数视频压缩、视频推理与视频存储,集成编码解码与转码能力,满足大规模视频处理需求。
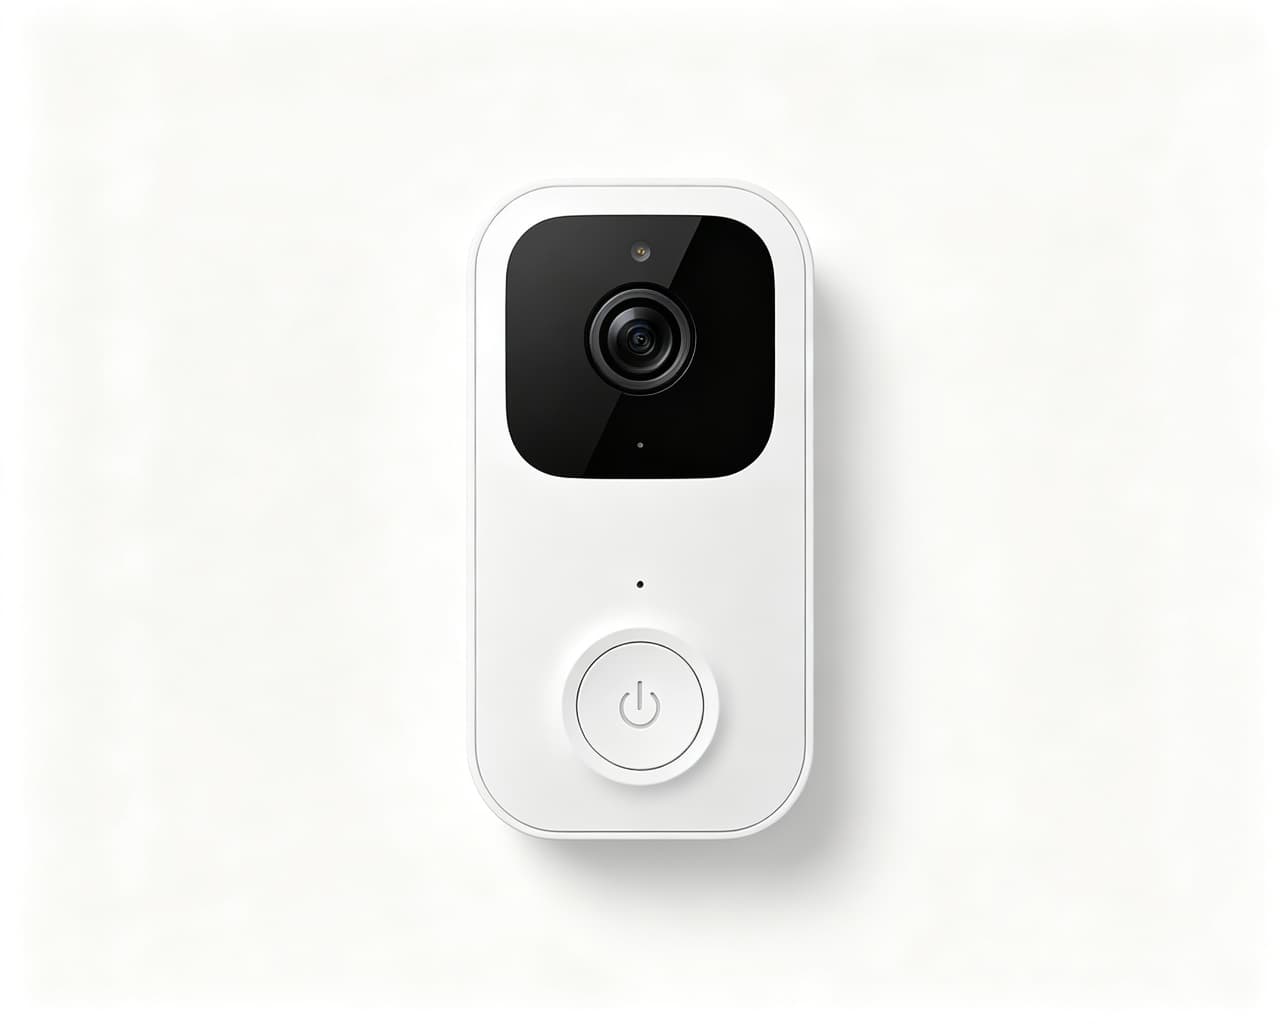
可视对讲智能门铃,支持人脸识别、远程对讲与移动侦测,适用于住宅与办公入口。
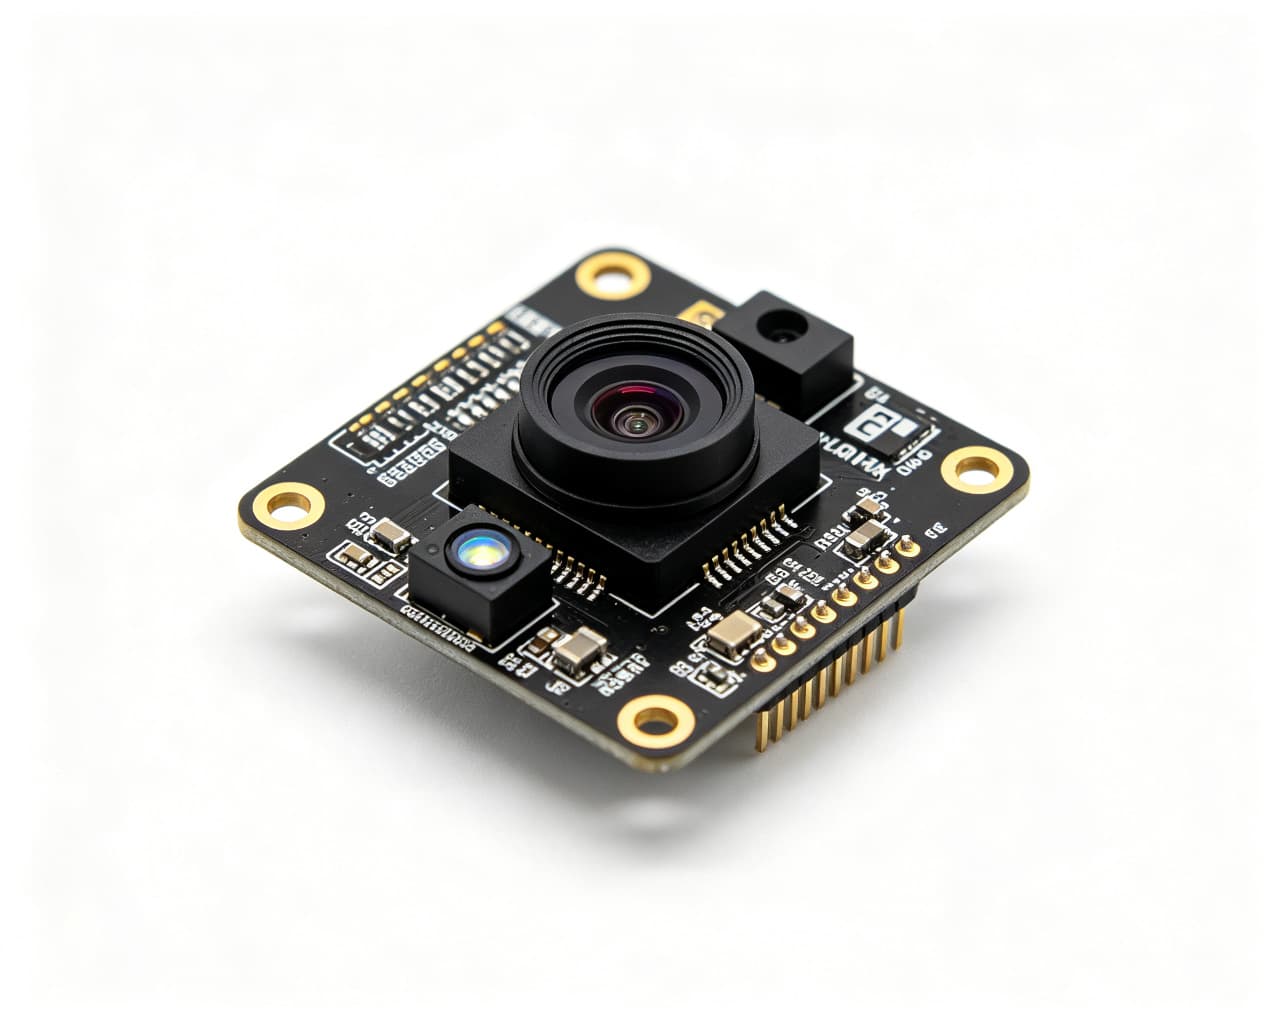
ToF 深度传感方案,高精度三维感知,支持体积测量、行为检测与空间建模。
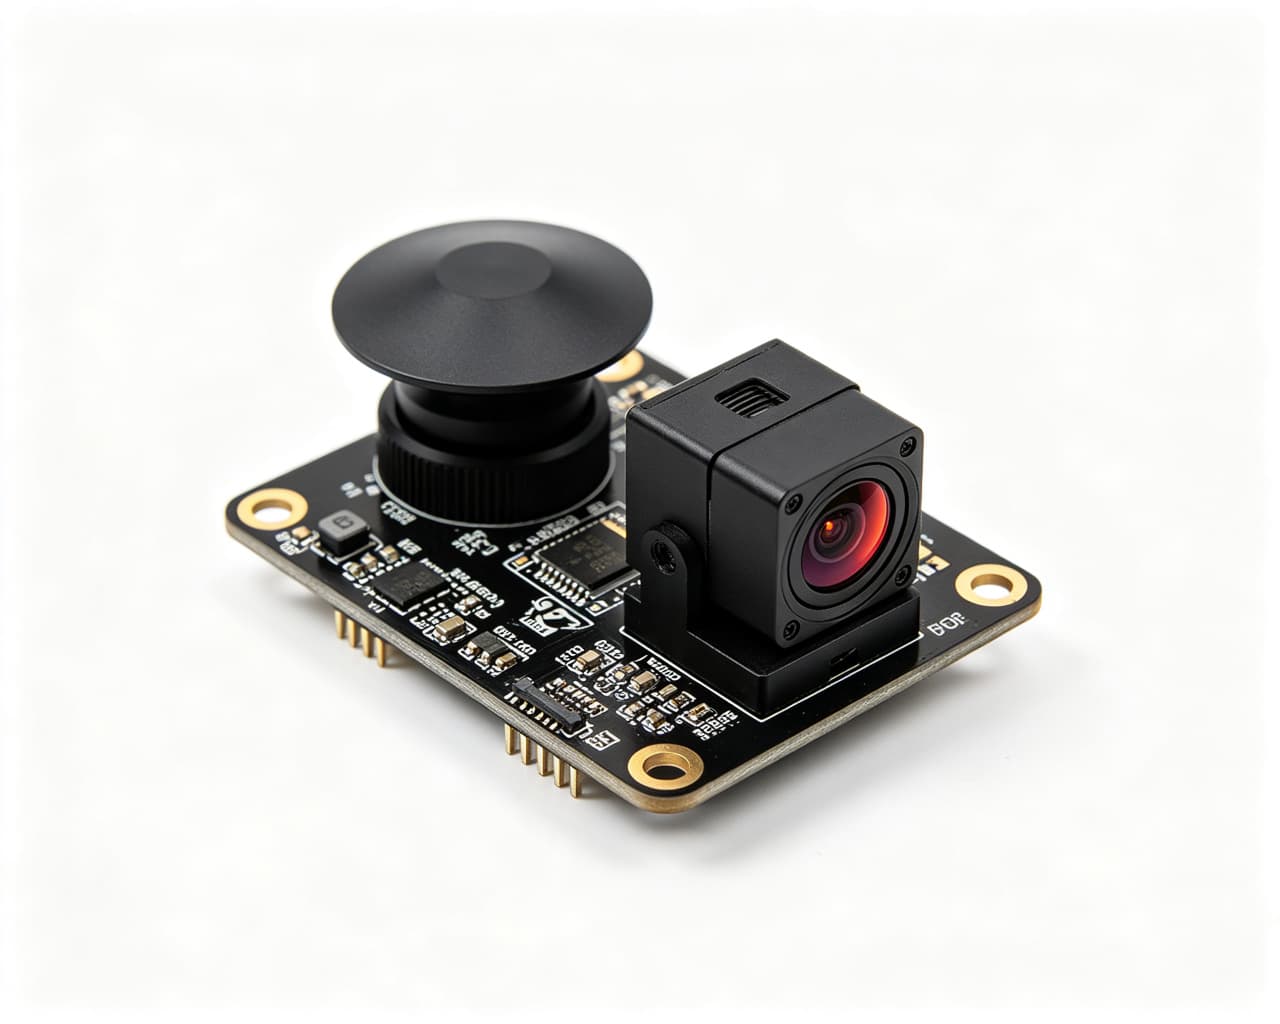
毫米波雷达与红外热成像融合感知,全天候全场景监测,不受光照与天气影响。
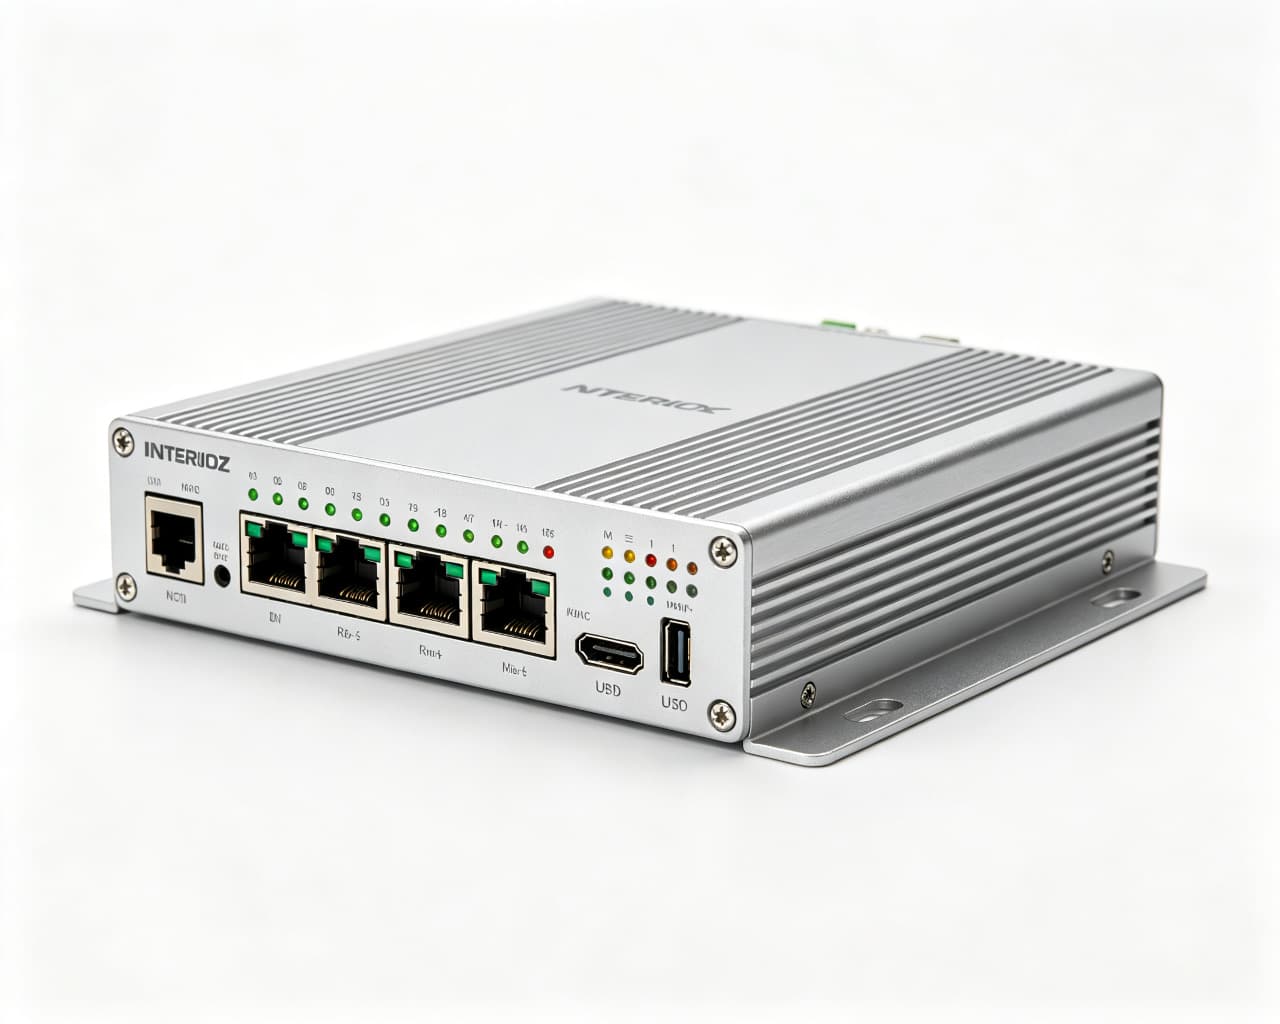
多协议物联网关,统一接入各类传感器与智能设备,边缘侧数据汇聚与联动控制。
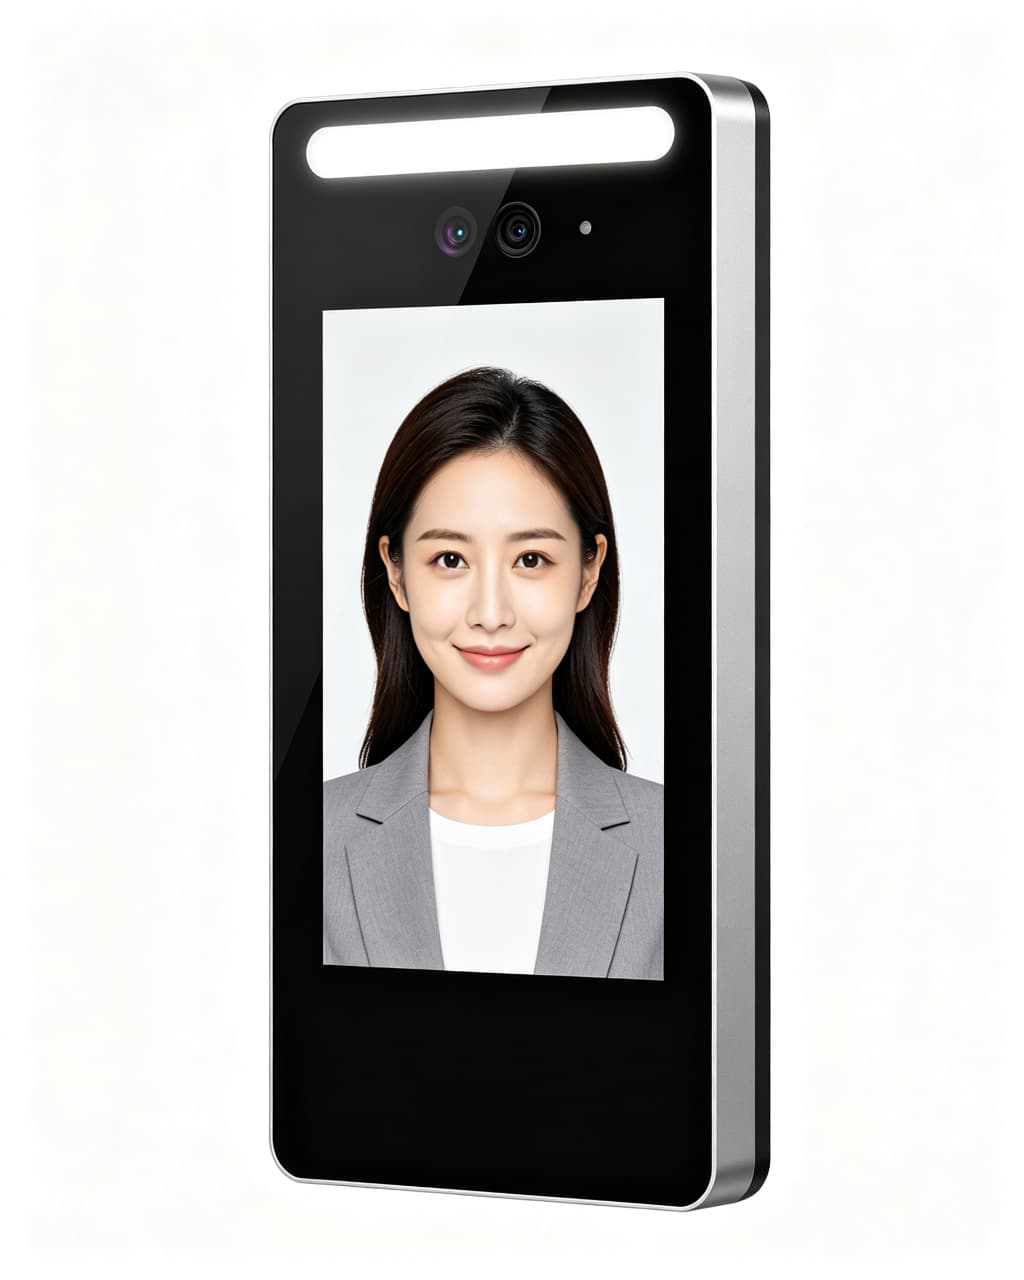
壁挂竖屏人脸识别门禁,支持活体检测、刷卡与密码认证,适用于园区社区出入口。
深度适配国内外主流 AI 芯片,算力选型灵活可控
GBOX 硬件生态深度适配国产化芯片及高性能通用芯片,采用统一的硬件架构与软件接口,可按算力需求、成本预算和国产化要求灵活选择方案。高性能通用路线覆盖终端到中心全形态,支持 NVIDIA 边缘终端芯片(Orin / Spark / Thor 等)与数据中心计算卡。
国产化阵营
12 家芯片厂商 · 多层级算力适配
高性能通用芯片
NVIDIA · 终端芯片 + 计算卡全形态覆盖
深度适配主流AI芯片,算力选型灵活可控
全国产化算力阵营 · 12家
高性能通用芯片阵营
更多芯片持续适配中 · 敬请期待
从轻量推理到高密度集群,按产品形态与业务负载分层选型。
轻量 / 标准 / 高算力 / 超算力四档
| 算力档位 | 算力区间 | 代表芯片 | 典型场景 |
|---|---|---|---|
| 微算力级 | 0.5 ~ 5 TOPS | 瑞芯微 酷芯 | 前端感知、轻量推理、摄像头端侧智能 |
| 中算力级 | 5 ~ 20 TOPS | 算能 瑞芯微 此芯 | 智能门禁、行为分析、结构化提取 |
| 高算力级 | 20 ~ 80 TOPS | 昆仑芯 登临 后摩智能 NVIDIA 终端 | 多路视频分析、人脸识别、复杂算法 |
| 超算力级 | 80 ~ 300 TOPS | 华为昇腾 海光 沐曦 天数智芯 摩尔线程 | 大模型推理、多算法协同、区域汇聚 |
面向高密度推理、训练与集群部署
| 算力档位 | 产品形态 | 代表芯片 | 典型场景 |
|---|---|---|---|
| 中算力级 | 入门级服务器 / 工作站 | 华为昇腾 NVIDIA 终端芯片 | 中小园区汇聚、轻型工作站计算 |
| 高算力级 | 2U/3U 机架服务器 / 工作站 | 海光 沐曦 天数智芯 摩尔线程 NVIDIA 计算卡 | 大模型推理、城市级汇聚、高密度计算 |
| 超算力级 | 4U 机架服务器 / 多卡集群 | 华为昇腾 910 海光 NVIDIA 高端计算卡 | 超大规模模型推理、算力集群调度 |
从训练平台到终端感知,全栈软硬件一体化协同设计
多框架兼容,分布式训练,针对全芯片架构模型量化优化
模型全生命周期管理,一键下发,推理效果监控与算力调度
全域设备统一接入,全生命周期管理,支持国产协议与通用协议
边缘计算终端与边缘计算主机双形态,覆盖轻量推理、高性能计算与高密度集群部署。
视觉、雷达、深度、热成像多维感知,构建前端智能感知网络
覆盖智慧安防、智慧交通、智能制造、公检法司等多行业,提供端到端算力硬件组合方案
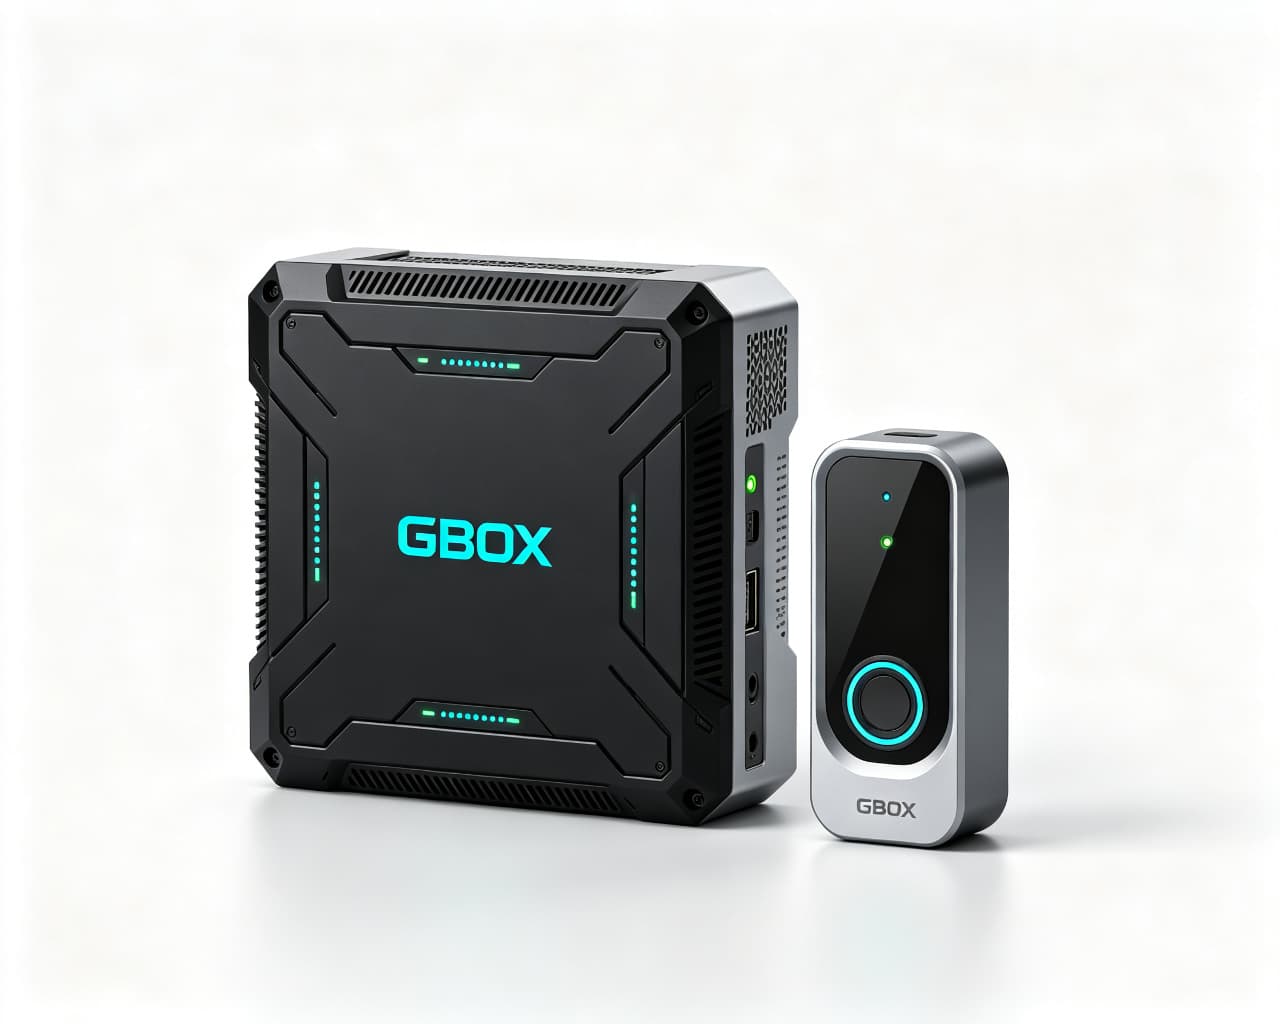
国产化标准算力终端 + 入门级工作站方案,满足政务园区信创要求与数据本地处理需求。
推荐硬件组合
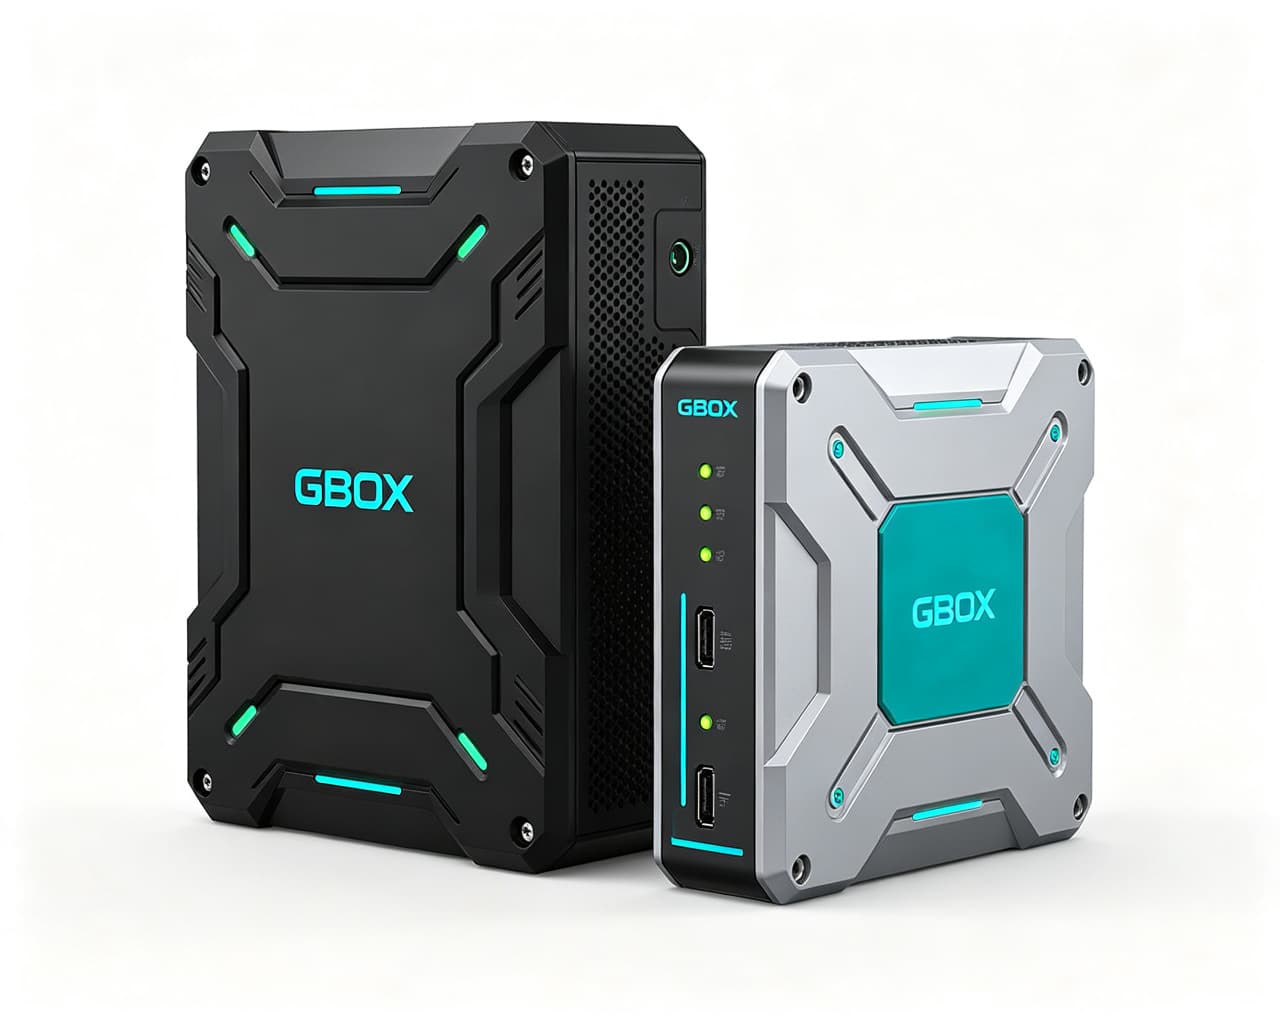
轻算力前端终端 + 2U区域汇聚服务器,实现园区安防、人员管理、能耗监控一体化。
推荐硬件组合
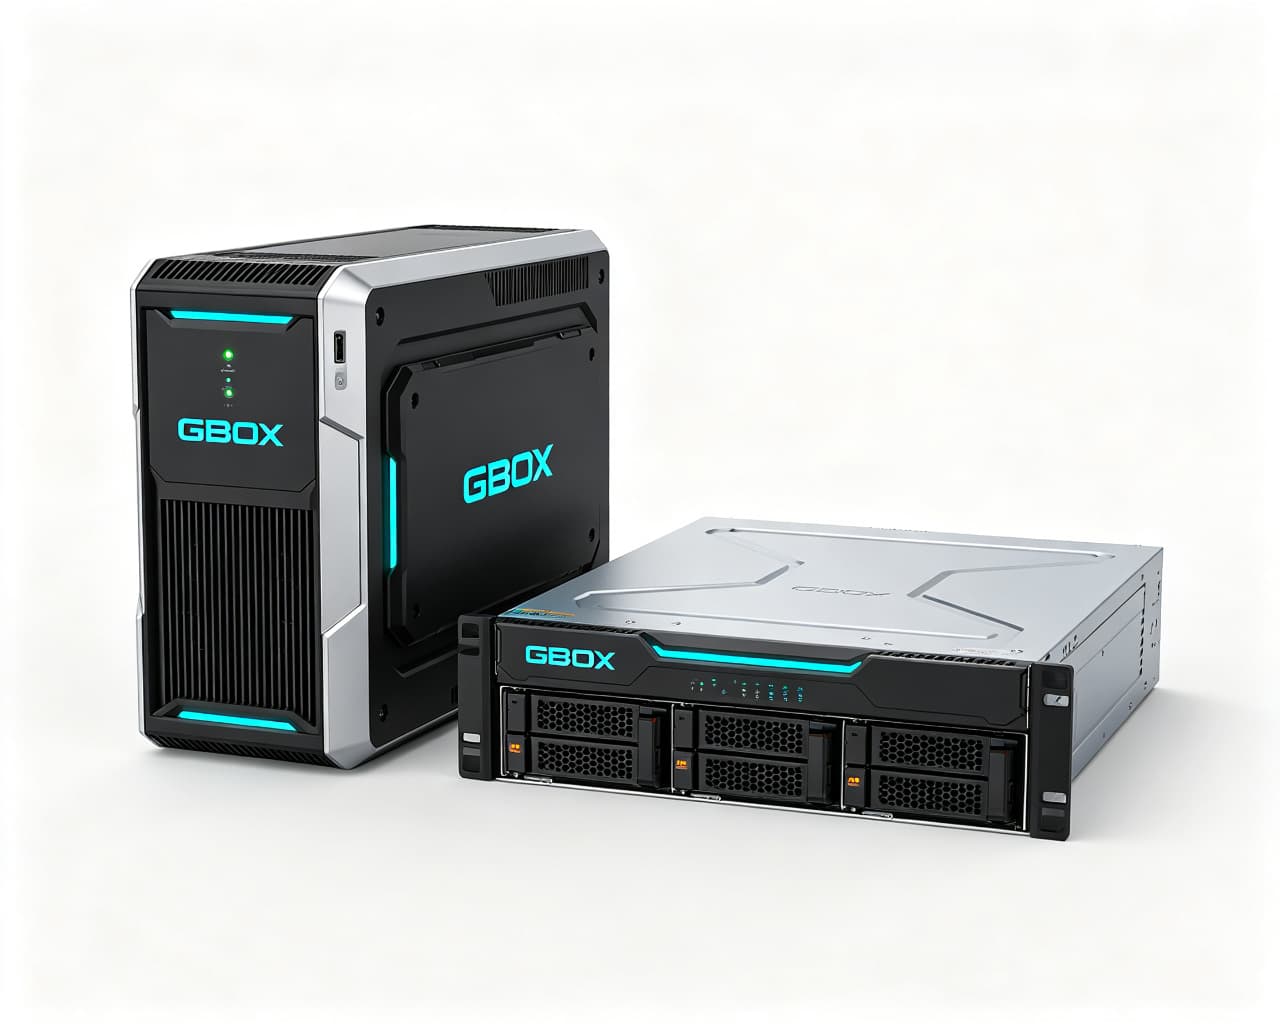
高算力路侧终端 + 4U多卡集群服务器,三级架构支撑城市级海量数据汇聚与智能分析。
推荐硬件组合
微算力质检终端 + 高性能工作站,实现缺陷检测、安全生产监控与预测性维护。
推荐硬件组合
全国产化标准算力终端 + 2U/3U安全可控服务器,满足智慧警务、司法监管、法院庭审等场景需求。
推荐硬件组合
专业技术团队,提供从方案设计到落地部署的全流程服务。无论是硬件定制、算法移植还是系统集成,我们都能根据您的业务需求提供定制化解决方案。
根据场景需求提供硬件定制开发,包括形态设计、接口扩展、算力配置等全方位定制服务。
支持主流框架模型的快速移植与性能优化,针对不同芯片平台深度调优推理性能。
提供软硬件一体化系统集成服务,打通端边云三层架构,实现数据互通与统一管理。
专业技术团队7×24小时响应,提供远程与现场技术支持,保障系统稳定运行。
把算法、路数与现场条件交给我们,获得硬件组合及部署建议。